 AVDR
Guia do mapa
Como usar (leia antes)
O que é. Um jeito de fazer carrossel com IA em que os slides parecem da mesma série: mesma luz, mesmo personagem, mesmo cenário. O segredo não está no modelo. Está em repetir as mesmas palavras em todos os pedidos e mudar só o que precisa mudar.
Onde roda. Eu descrevo o carrossel no Claude Code, e ele escreve o brief, monta os prompts e compõe o texto por cima. A imagem sai de um gerador: usei o Nano Banana Pro, na Higgsfield, a 2 créditos por imagem. O carrossel inteiro custou 18 créditos, com 9 imagens geradas para 6 slides.
O que não é. Não é "pede o carrossel inteiro". É exatamente o contrário.
Por que a maioria desiste
Pede o carrossel inteiro de uma vez. Cada slide volta com uma luz, uma roupa e uma câmera diferentes, e a conclusão é que a IA não serve.
O gerador não lembra do slide anterior: cada pedido começa do zero. Quem costura a série é você, com as mesmas referências e as mesmas frases em todos os pedidos.
Passo 1: separe as duas âncoras
Duas imagens que você já aprovou: uma do cenário e uma do personagem (ou do produto). Elas vão anexadas em todo pedido, sempre na mesma ordem.
No carrossel SLIDES foram a sala de comando de um Reels que já tinha saído e o Ninja da marca. Se o seu carrossel não tem personagem, a segunda âncora é o produto, a embalagem ou o seu escritório.
Passo 2: escreva o brief visual em 6 blocos
O brief é o texto que vai em todos os pedidos. Ele tem seis blocos, e quatro deles nunca mudam:
- 1. Cenário (fixo): o que usar da primeira referência.
- 2. O que ignorar (fixo): por exemplo, a pessoa que aparece na foto do cenário.
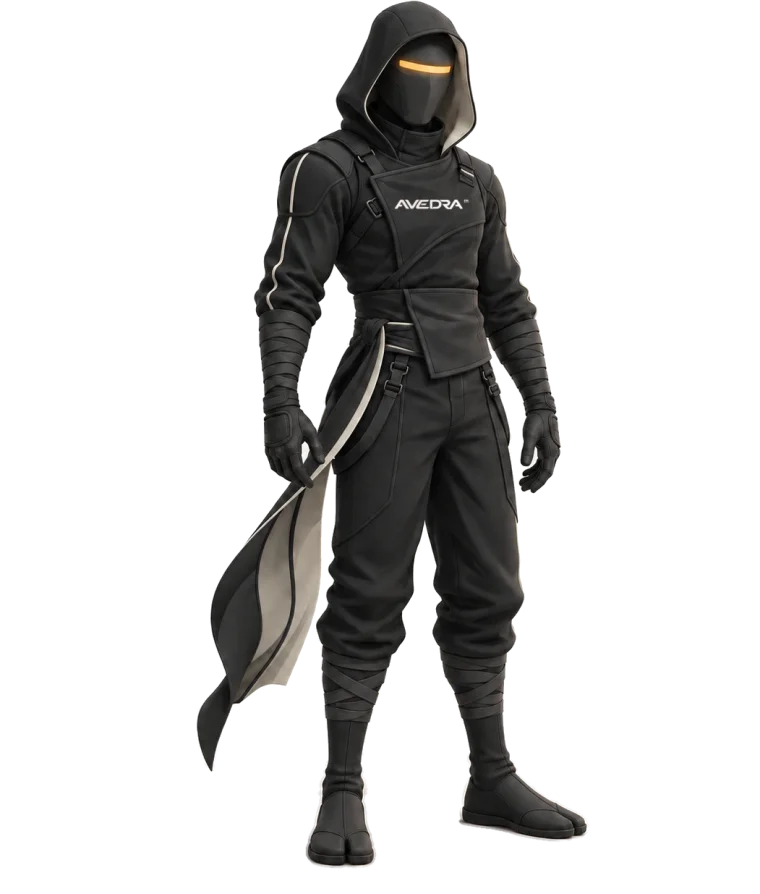
- 3. Personagem (fixo): como ele é e, em maiúsculas, o que ele não pode ser. Foi isso que segurou a roupa escura: "NOT light grey, NOT white".
- 4. Ação (muda por slide): o que o personagem está fazendo.
- 5. Câmera (muda por slide): de onde a cena é vista.
- 6. Proibições (fixo): sem texto, sem letra, sem tela, sem tarja preta.
Os prompts ficam em inglês porque o gerador obedece melhor. Modelo para preencher:
Use the [SETTING] from the first reference image: [3 to 5 visual details: walls, light, furniture, floor].
IGNORE the person in the first reference image. The only person is the [CHARACTER] from the second reference image.
Character: [who it is], [clothing and colors], NOT [wrong color 1], NOT [wrong color 2]. [What must never appear, in CAPS].
Action: [what the character does in THIS slide].
Camera: [where the camera is and what fills the frame in THIS slide].
Cinematic film still, volumetric haze, fine grain, deep shadows, [accent color] accent light. The upper quarter of the frame is [empty area for the headline].
Full bleed image, no letterbox, no black bars, no text, no letters, no numbers, no screens, no panels, no user interface.
E este é o prompt real da capa, do jeito que foi usado:
Use the circular dark room from the first reference image: curved dark walls, vertical white light strips, round ring light on the ceiling, round table with a glowing amber ring edge, polished dark floor. IGNORE the person in the first reference image. The only person is the ninja from the second reference image. Character: a ninja in a DARK GRAPHITE, NEARLY BLACK hooded suit with thin amber trim, NOT light grey, NOT white, NOT beige. RIGID CLOSED HELMET MASK with NO eyes, NO mouth, NO face visible, only a single horizontal amber light bar across the visor, dark gloves, waist pouch, one sheathed katana on the back. Action: the ninja stands behind the round table with both gloved hands raised, palms open, as if conjuring something. A soft cone of amber light rises from the table ring into the empty air above the table, which stays empty and glowing. Camera: worm eye view from floor level in front of the table, strongly tilted up, the ninja and the light cone towering over the camera. Cinematic film still, anamorphic feel, volumetric haze, fine grain, deep shadows, cool dark room with amber accent light. The upper quarter of the frame is dark ceiling haze. Full bleed image, no letterbox, no black bars, no text, no letters, no numbers, no screens, no panels, no user interface.
Passo 3: faça 3 versões da capa
Com o brief pronto, gere a capa três vezes, mudando só a ação e a câmera. Escolha nesta ordem:
- Identidade certa. Roupa, cor e rosto (ou a falta dele) do jeito que a marca é.
- Espaço para o texto. Um quarto do quadro vazio, onde a manchete vai entrar.
- Luz que se repete. Se a luz boa foi sorte, o resto da série não acompanha.
No SLIDES, a versão A saiu com a roupa clara e foi descartada, a B virou a âncora e a C ficou de fora. As três aparecem no slide 4 do carrossel.
Passo 4: clone a âncora, um slide por vez
Um pedido por imagem. Anexe as mesmas duas referências, copie os blocos 1, 2, 3 e 6 palavra por palavra e troque só a ação e a câmera. Os seis ângulos deste carrossel:
- Slide 1: de frente e de baixo para cima, o personagem conjurando.
- Slide 2: por cima do ombro, diante da bagunça.
- Slide 3: de costas e pequeno, diante do cone de luz.
- Slide 4: três quartos, debruçado na mesa.
- Slide 5: de perfil, apontando.
- Slide 6: de frente, atrás da mesa, para a chamada final.
Um pedido por vez tem outra vantagem: quando um slide sai errado, você refaz só ele, com o mesmo prompt.
Para o Claude Code montar tudo isso por você, cole este pedido com as duas imagens anexadas:
Vou fazer um carrossel de [número] slides sobre [tema]. Anexei duas imagens de referência: a 1ª é o cenário e a 2ª é o [personagem ou produto].

1. Escreva o brief visual em 6 blocos: cenário, o que ignorar, personagem (com o que ele NÃO pode ser, em maiúsculas), ação, câmera e proibições. Em inglês.
2. Me dê 3 prompts da capa, mudando só ação e câmera. Espere eu escolher.
3. Com a capa escolhida, escreva um prompt por slide. Os blocos de cenário, o que ignorar, personagem e proibições ficam idênticos, palavra por palavra. Só ação e câmera mudam.
4. Nenhum texto dentro da imagem. Me devolva, separado, o texto exato de cada slide, para eu compor por cima.
Passo 5: o texto entra depois, nunca na imagem
Gerador de imagem inventa letra. Painel, tela e placa voltam com caracteres que não existem. Por isso o bloco de proibições pede "no text, no letters, no screens", e a imagem vem com um espaço vazio de propósito.
O texto de cada slide é escrito antes, exato, e composto por cima da imagem: no Canva, no Figma ou num script. Aqui foi um script que o próprio Claude Code escreveu, com a mesma fonte, o mesmo tamanho e a mesma posição em todos os slides. Os hologramas com as imagens de verdade também entraram nessa etapa.
Antes de publicar: a conferência
- O personagem tem a mesma roupa e a mesma cor em todos os slides?
- A luz vem do mesmo lado e na mesma cor?
- O espaço do texto está no mesmo lugar?
- Sobrou alguma letra inventada, tarja preta ou tela com rabisco?
- O texto de cada slide foi conferido letra por letra depois de composto?
Limites deste guia
- Os números são deste carrossel, feito em 19/09/2026: 9 imagens geradas para 6 slides, 18 créditos, 3 descartadas (duas pela roupa clara e uma capa que perdeu na escolha).
- Nem tudo segurou. Mesmo com o prompt travado, a roupa do Ninja clareia com a luz na capa e nos slides 5 e 6. Dá para ver no carrossel, e eu aprovei assim.
- O close no visor do personagem foi recusado pela plataforma, provavelmente por semelhança com personagem protegido. Se o seu personagem lembra algum famoso, conte com isso.
- O método vale para qualquer gerador que aceite imagem de referência. Preço e obediência à câmera mudam de um para outro: no teste de 19/09, o Nano Banana Pro obedeceu à câmera nos 3 ângulos pedidos e o modelo mais barato da mesma plataforma não obedeceu em nenhum.
GRUPO DO WHATSAPP
Os próximos guias saem primeiro no grupo
É onde eu mando o material novo e respondo dúvida de quem está montando o próprio sistema. Entrar e sair é livre.
Entrar no grupo do WhatsApp